https://www.sciencedirect.com/science/article/pii/S1361841525000519
1. Introduction
- 현대 의료 의사 결정에 있어 환자의 포괄적인 이해를 위해 의료 영상과 임상, 인구 통계, 유전 정보 등의 다양한 modality를 통합하는 것이 중요
- 딥러닝은 다양한 멀티모달 의료 작업에서 뛰어난 성능을 보이지만, 고차원적이고 연속적인 영상 데이터와 저차원적이며 다양한 유형을 가진 tabular 데이터를 효과적으로 통합하는 데 어려움
- CLIP과 같은 VLM은 텍스트와 이미지 간의 관계를 잘 포착하지만, 의료 분야에서는 데이터 분포가 균일하지 않고 명시적인 일대일 의미론적 매핑이 없어 적용하기 어려움
- 영상 데이터와 달리 tabular 데이터는 스캔된 해부학적 구조와 직접적인 상관관계가 없는 보완 정보를 제공함. 이러한 데이터는 별개의 정보이지만 함께 사용될 때 진단 정확도를 향상시킬 수 있음
- 저자들은 hypernetworks 기반의 새로운 프레임워크인 HyperFusion을 제안함.
- 이 프레임워크는 tabular 데이터를 사전 정보로 활용하여 영상 분석 네트워크의 출력을 conditioning함.
- 이는 tabular 데이터의 값에 따라 이미지 처리 네트워크가 동적으로 조정되는 방식
2. Related Work
Fusion methods
다양한 의료 데이터를 통합하는 것은 오랜 연구 분야이지만, 특히 영상 데이터와 tabular 데이터의 융합은 최근 더 많은 주목을 받고 있음
- Eary fusion : 원본 데이터 또는 추출된 특징을 input level에서 concate하는 방식. 이는 Mutual learning 가능성이 제한적
- Joint/intermediate fusion : 특징 추출 단계가 융합 모델의 일부로 학습되는 방식. 저자들이 택한 방식이며, 이는 모달리티 간 의미있는 상호작용을 가능하게 함
- Late fusion : 예측값 또는 사전 학습된 고수준 특징을 결정 단계에서 결합하는 방식. 이 방법 역시 모달리티 간의 심층적인 상호 학습을 촉진하지 못함
본 연구에서는 hypernetwork를 사용하여 이미지 처리 과정을 표 데이터에 conditioning 함. 이는 기존 방법과 달리, hypernetwork가 주 네트워크의 특정 계층 파라미터를 일반적인 변환을 통해 적응시키는 포괄적인 접근 방식
Hypernetworks
- 하나의 네트워크가 다른 네트워크의 weights와 bias를 생성하는 개념
- 의료 분야에서 서로 다른 데이터 모달리티를 융합하기 위해 hypernetwork를 사용하는 것은 본 연구가 처음
Brain age prediction
- 뇌 영상 데이터를 기반으로 인간의 연령을 예측하는 연구는 활발히 진행되어 왔으나, 대부분의 기존 연구는 영상 데이터에만 의존함
- 본 연구에서는 성별 정보의 통합이 뇌 연령 예측 정확도를 향상시킬 수 있는지 탐구하며, 피험자의 성별에 따라 조건화된 뇌 연령 추정 과제를 다룬 최초의 연구
Multi-class AD classification
- 뇌 MRI를 통해 AD를 조기 진단하는 것은 중요하며, 이 연구는 이진 분류가 아닌, CN, MCI, AD의 다중 클래스 분류에 초점을 맞춤
- 많은 연구가 영상 데이터에만 의존하지만 신경학 문헌은 임상 및 인구 통계 데이터의 포함이 예측을 향상시킬 수 있음을 시사함
3. Method
3.1. Hyperfusion

논문에서 제안하는 Hyperfusion 프레임워크는 하이퍼네트워크 , 주 네트워크 로 이루어짐
동작 순서는 다음과 같음
- 하이퍼네트워크는 input tabular data 을 받아 주 네트워크의 특정 계층에 필요한 파라미터 를 생성
- 주 네트워크는 이미지 데이터 를 입력으로 받아 내부적으로 학습된 파라미터 와 하이퍼네트워크가 생성한 파라미터 를 함께 사용하여 예측을 수행
- 주 네트워크의 외부 계층(위 그림에서 빨간 부분)은 에 따라 동적으로 조정됨
- loss는 주 네트워크와 하이퍼네트워크를 통해 모두 역전파되며, 와 는 직접 업데이트되고 는 하이퍼네트워크를 통해 간접적으로 업데이트 됨
- low-level 주 네트워크 계층의 파라미터는 내부적으로 유지하고, high-level 계층의 파라미터는 하이퍼네트워크가 생성하도록 하여, 학습 데이터 활용을 극대화하면서 tabular 데이터를 통한 추가적인 이득을 얻도록 함
3.1.1. Embedding the tabular data
- Tabular data 는 먼저 임베딩 네트워크 을 통해 저차원 잠재 벡터로 매핑됨
- 공간적 맥락이 없는 tabular 데이터에는 MLP를 임베딩 네트워크로 사용
- 이 임베딩 벡터는 다시 두 개의 linear layer를 거쳐 가중치와 편향을 생성
- 임베딩 파라미터는 전체 네트워크와 함께 end-to-end로 학습
3.1.2. Hyperlayer’s position selection
- 주 네트워크의 어떤 계층을 하이퍼네트워크가 제어할 “hyperlayer”로 선택할지는 backbone 네트워크의 각 계층의 영향을 평가하여 결정
- 특정 계층의 파라미터를 무작위로 초기화하고 loss entropy를 측정하여 해당 계층의 영향을 파악
3.1.3. Weights initialization
- 하이퍼네트워크가 생성하는 주 네트워크의 파라미터 는 입력 샘플 에 따라 달라지기 때문에 직접 초기화할 수 없음
- 각 하이퍼네트워크 의 파라미터 를 초기화함. 이는 하이퍼네트워크의 출력이 주 네트워크의 해당 계층에서 입력 분산과 출력 분산이 일치하도록 함
- 가중치 와 편향 의 분산은 아래와 같이 초기화 됨
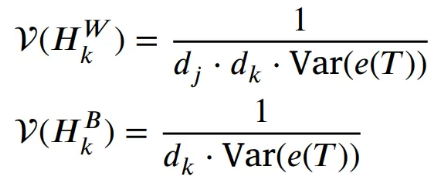
- 여기서 는 주 네트워크 계층의 fan-in 크기, 는 하이퍼네트워크의 fan-in 크기, 는 임베딩된 tabular 데이터의 분산
3.2. Loss functions
전체 손실은 태스크별 손실 와 가중치 감소 정규화 항 의 합
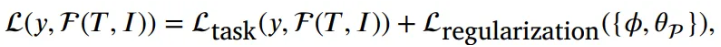
여기서 는 실제 레이블이고 에는 정규화가 적용되지 않음
- Regression Task의 경우 예측값과 실제값 간의 MSE (Mean Square Error)를 사용
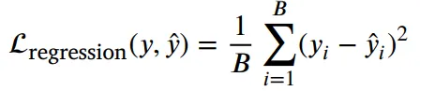
- Classification Task의 경우 클래스 불균형을 고려하여 WCE (Weighted Cross-Entropy) 손실을 사용
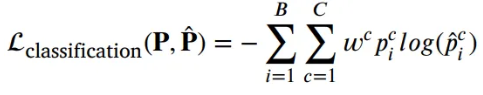
3.3. Missing values
- Tabular 데이터의 결측값을 반복적인 방법을 사용하여 처리
- 각 단계에서 한 column을 출력으로, 나머지 column을 입력으로 간주하고, 누락되지 않은 값으로 regressor를 학습시킨 다음, 해당 속성의 누락된 값을 예측
- NaN flag를 추가
3.4. Ensemble Learning
추론 과정을 강화하고 안정화하기 위해 개의 학습된 모델 부터 까지의 결과를 집계
- Regression: 모든 앙상블 모델의 예측값의 단순 평균을 사용
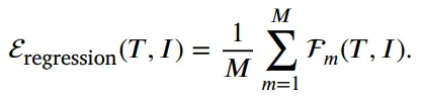
- Multi-Class Classification: 예측 확률 분포의 가중 평균을 사용.
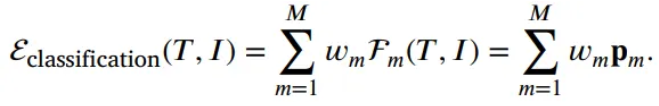
- 이 때 각 모델 의 가중치 은 해당 예측의 엔트로피에 반비례함
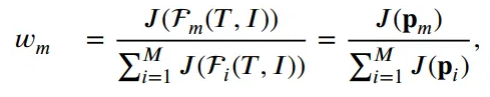
3.5. Imaging-tabular data fusion applications
3.5.1. Conditioned brain age prediction using hypernetworks
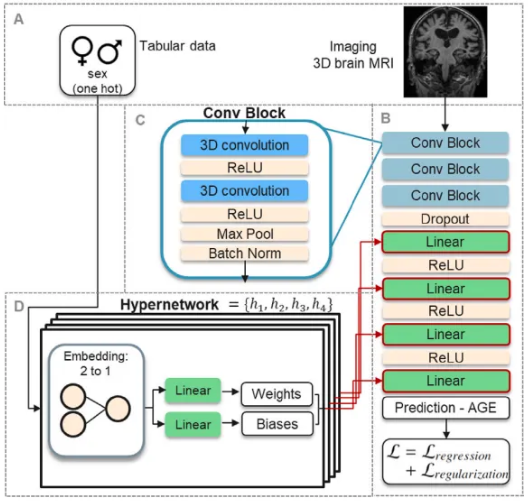
- Input: 주 네트워크는 3D 뇌 MRI 스캔, 하이퍼네트워크는 피험자의 성별
- 주 네트워크: VGG backbone의 변형을 사용하고, 하이퍼네트워크는 주 네트워크의 마지막 4개 linear layer의 파라미터를 생성
3.5.2. AD classification using hypernetworks
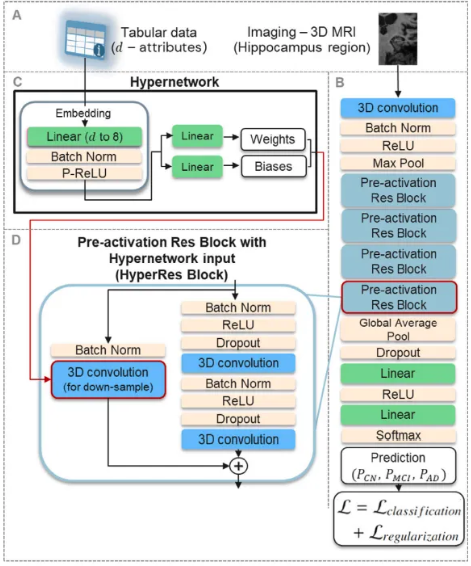
- Input: 주 네트워크는 해마 및 주변 조직으로 크롭된 3D 뇌 MRI 스캔, 하이퍼네트워크는 9가지 임상 및 인구 통계 속성
- 주 네트워크: 사전 활성화 ResNet 블록. 하이퍼네트워크는 마지막 ResNet 블록 내의 한 convolution layer에 파라미터를 제공
4. Experiment
4.1. Experimental details
논문 원문 참고
4.2. Brain age prediction conditioned by sex
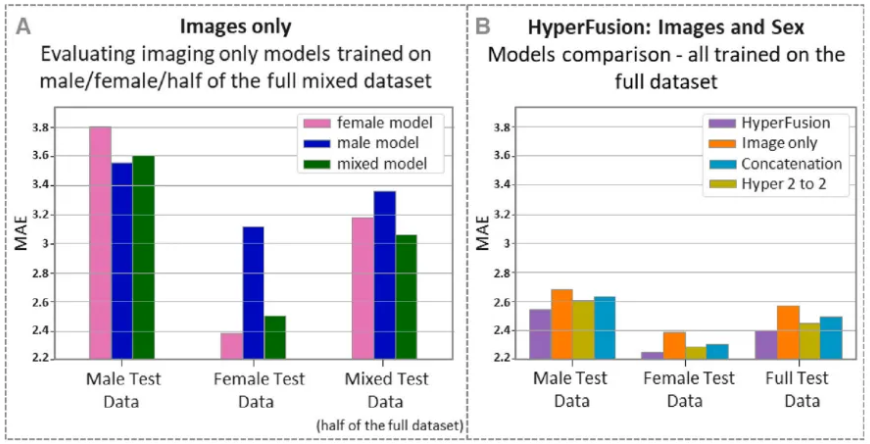
- A에서는 성별이 뇌 연령 예측에 중요한 영향을 미치는 요소임을 보여주며, 이는 제안된 HyperFusion 프레임워크가 성별 정보를 통합하여 예측을 개선하려는 동기를 부여하는 기준선 역할을 함
- B는 HyperFusion이 뇌 연령 예측 task에서 SOTA 성능을 달성하며, 의료 영상과 tabluar 데이터의 지능적인 융합을 위한 강력하고 효과적인 프레임워크임을 분명하게 입증하였음
4.3. Multi-class AD classification
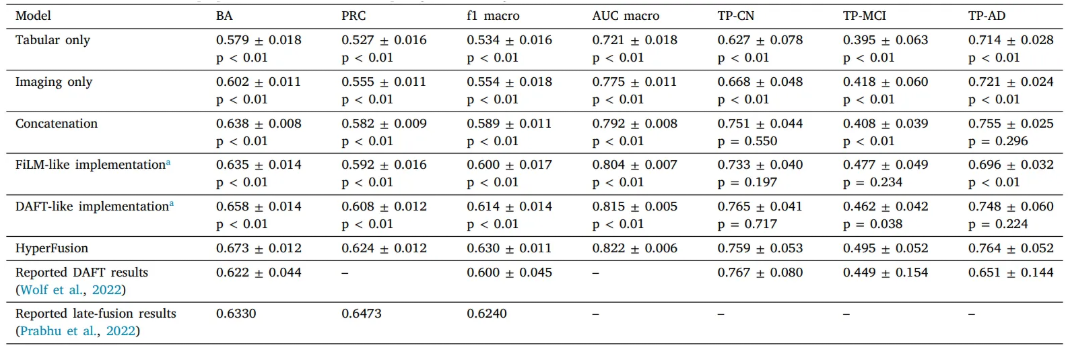
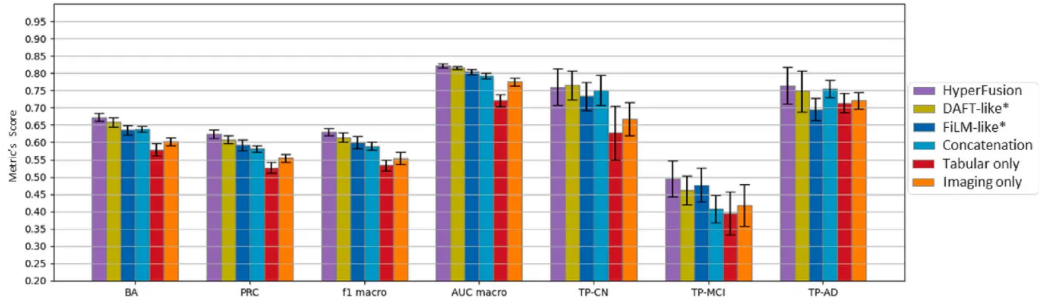
- 본 논문에서 제안한 HyperFusion은 거의 모든 평가 지표에서 다른 모델보다 가장 높은 성능을 보여줌
- HyperFusion을 포함한 모든 multi-modal 융합 모델들은 단일 모달 모델보다 전반적으로 나은 성능을 보여주었으며, 이는 여러 종류의 데이터를 통합하는 것이 진단 정확도를 향상시키는 데 중요함을 시사

큰 사람이 되겠어요