[논문 리뷰] Root cause identification of fault in hot-rolling process by causal plot (DCE 2024)
논문리뷰
목록 보기
36/36
https://www.sciencedirect.com/science/article/pii/S277250812500047X
Introduction
- 열간 압연은 슬래브를 고온으로 가열한 뒤 여러 롤러로 압착하여 강판을 만드는 Batch 방식의 공정
- 가동 중에 이상이 생기면 규격에 맞지 않는 불량(Off-spec) 제품이 생산되며, 이를 해결하기 위해 정확한 원인 파악이 필수적
- 압연 과정 중의 재료 변형은 온도, 하중, 재료 특성 등이 복잡하게 얽혀 있어 정확한 물리, 화학적 모델을 만드는 것이 매우 어려우며, 실험실 규모의 연구 결과와 실제 공정 현장 데이터 사이에는 큰 차이가 존재
- 따라서 최근에는 실제 공정 데이터를 활용한 통계적 접근 방식이 주목받고 있음
- 가장 대중적인 MSPC 기반의 Contribution Plot은 변수 간의 상관관계에 집중하는데, 만약 하나의 변수가 여러 변수를 동시에 제어하고 있다면, 상관관계만으로는 진짜 원인과 단순히 그 원인 때문에 변한 결과들을 구별하기 어려움
- 저자들은 이러한 한계를 극복하기 위해 Causality를 분석하는 causal plot을 배치 공정에 맞게 개량한 b-causal plot을 제안하고자 함
- 데이터로부터 변수 간의 인과 구조를 스스로 찾아내는 LiNGAM 모델을 활용하여 모니터링 지표에 직접적인 원인을 제공하는 변수를 찾아냄
- 배치 공정은 각 배치마다 데이터의 길이가 달라 인과 분석이 어려운데, 이를 위해 Dynamic Time Warping (DTW)을 도입하여 서로 다른 길이의 데이터를 정렬하고 고정된 길이로 변환함.
- 실제 제철소의 운전 데이터를 분석하여, 숙련된 엔지니어조차 평소에 주의 깊게 보지 않는 사소한 변수가 사실은 고장의 근본 원인이었음을 밝혀낼 수 있음을 증명하고자 함.
Conventional methods
Contribution plot
이 방법은 다변량 통계적 공정 관리(MSPC)를 기반으로 하며, 변수들 사이의 상관관계를 이용해 이상을 탐지하고 원인을 추정함
- PCA modeling: 정상 운전 데이터 를 특이값 분해하여 PCA를 수행
- 모니터링 지표
- Hotelling’s statistics: 주성분 공간 내에서의 마할라노비스 거리를 측정
- statistics (SPE): 샘플과 주성분 공간 사이의 수직 거리를 측정하여 상관관계의 변화를 감지
- 원인 추정: 이상이 감지되면 각 변수 이 나 에 기여한 정도를 계산. 기여도가 큰 변수가 고장의 원인으로 추정됨
- 하지만 인과관계가 아닌 상관관계에 기반하므로, 여러 변수가 동시에 변할 때 진짜 원인 변수를 짚어내지 못할 수 있음
LiNGAM
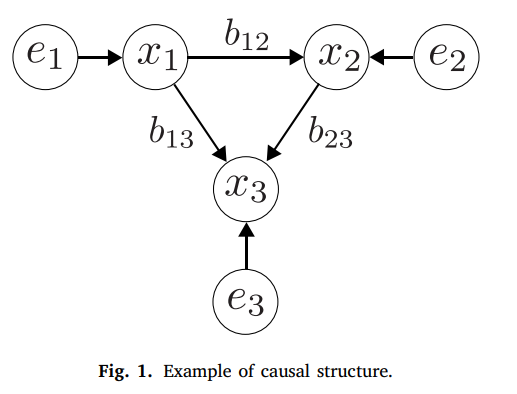
사전 지식 없이 데이터로부터 변수 간의 인과 방향과 강도를 추정하는 통계 모델
-
변수들이 선형 관계를 가지고, 오차항(외생 변수)이 비가우시안 분포를 따르며, 인과 구조에 순환이 없다고 가정
-
개의 관측 변수 에 대해 아래와 같이 정의됨
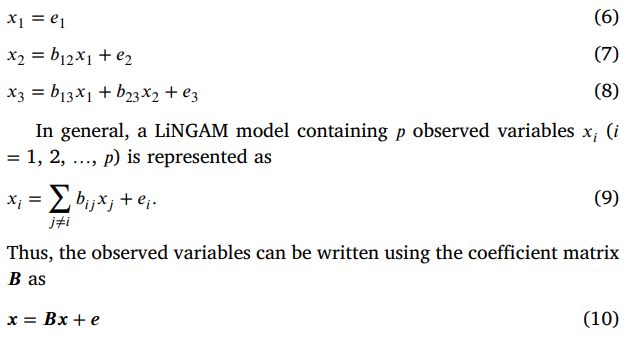
여기서 계수 행렬 를 통해 어떤 변수가 다른 변수의 원인이 되는지 파악
-
Causal plot
LiNGAM을 고장 진단에 결합한 것
- 공정 변수들에 MSPC로 계산한 모니터링 지표 를 하나의 변수로 추가하여 데이터셋 를 생성
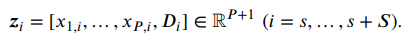
- LiNGAM을 통해 계산된 계수 행렬 에서 와 연결된 열 벡터 을 추출. 이 벡터의 값이 큰 변수가 지표 를 변화시킨 직접적인 원인으로 간주됨
Dynamic time warping
배치 공정처럼 데이터 길이가 제각각인 시계열 데이터를 비교하고 정렬하기 위해 사용
- 두 시계열 데이터 사이의 거리를 최소화하는 Warping path를 찾아 데이터를 확장하거나 축소하여 길이를 맞춤
- 서로 다른 시점의 데이터를 동일한 공정 단계상에서 비교할 수 있게 하여, 고정된 데이터 길이를 요구하는 알고리즘을 적용할 수 있게 함
b-causal plot
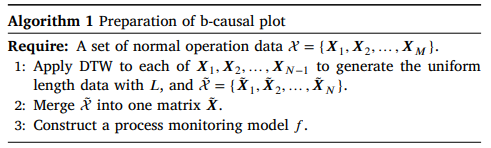
공정 모니터링 모델 구축
- 수집된 개의 정상 배치 데이터셋 중 최대 길이 을 기준으로, DTW를 적용하여 모든 데이터의 길이를 동일한 길이 로 변환
- 정렬된 데이터들을 하나의 행렬 로 병합
- 통합된 데이터를 사용하여 PCA 기반의 공정 모니터링 모델 를 학습
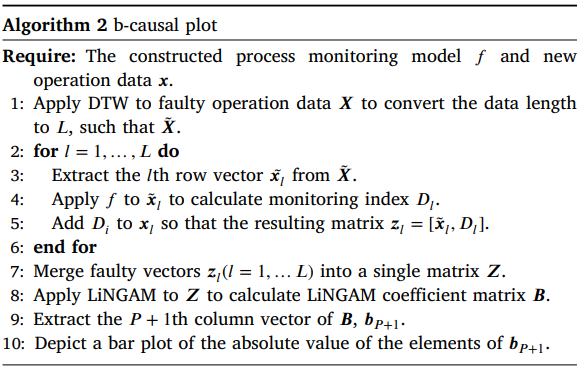
고장 원인 식별: 새로운 불량 배치가 발생했을 때, 그 원인이 된 변수를 찾아내는 과정
- 발생한 불량 데이터 의 길이를 DTW를 통해 표준 길이 로 변환
- 변환된 데이터의 각 시점 마다 미리 학습된 모델 를 적용하여 또는 와 같은 모니터링 지표 을 계산
- 각 시점의 공정 변수 벡터 에 계산된 지표 을 추가하여 확장된 벡터 을 생성하고, 이를 다시 행렬 로 만듦
- 확장 행렬 에 LiNGAM 알고리즘을 적용하여 변수 간 인과 계수 행렬 를 구함
- 행렬 의 마지막 열(P+1번째 열) 벡터 을 확인. 이 벡터의 각 원소는 각 공정 변수가 모니터링 지표 에 미치는 인과적 영향력의 크기를 나타냄
- 의 절대값을 막대 그래프로 그려 인과성이 가장 큰 변수를 근본 원인으로 지목
Analysis of hot-rolling process
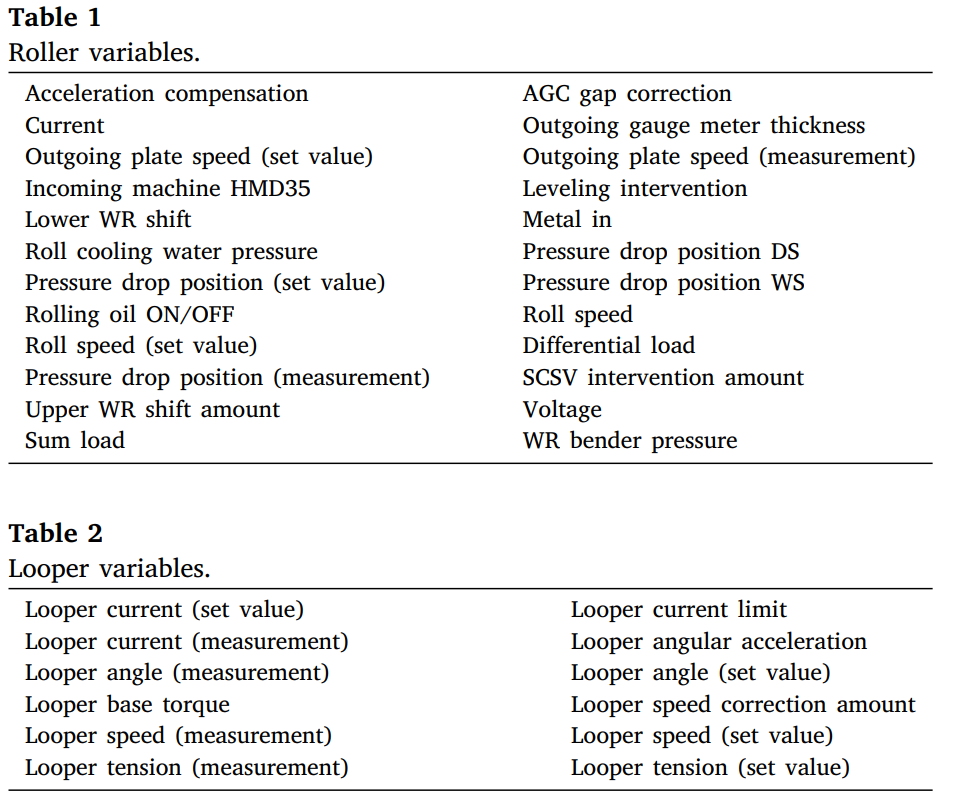
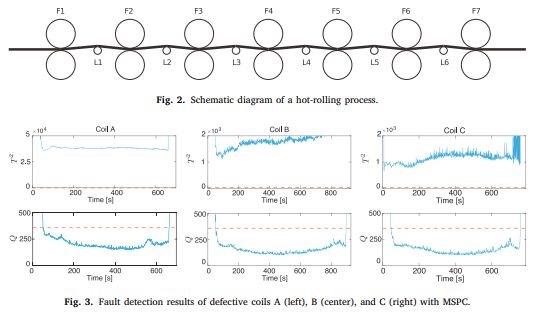
- 총 241개의 변수 중 고정값을 제외한 151개가 최종 분석에 사용됨
- 이는 매우 다변량적인 공정이며, 사람이 일일이 상관관계를 파악하기 어려운 구조임을 보여줌
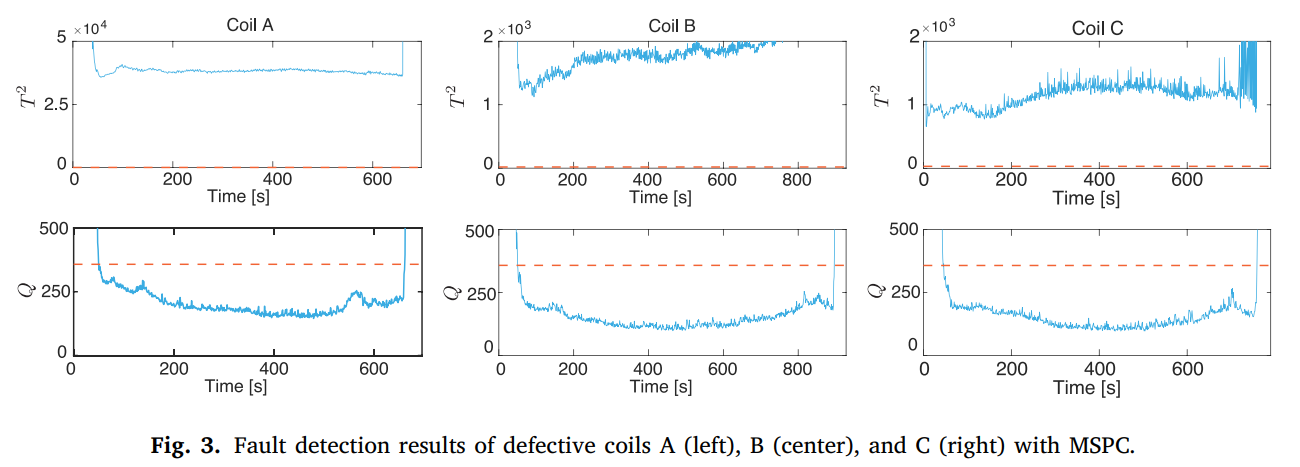
- 세 개의 불량 코일(A, B, C)에 대해 MSPC 모델을 적용한 결과
- 모든 불량 코일에서 통계량이 제어 한계치를 크게 초과하는 반면, 통계량은 시작과 끝부분을 제외하고는 한계치 아래에 있음
- 이는 공정의 변수 간 상관관계 구조 자체가 정상 범위에서 크게 벗어났음을 의미하며, 통계량이 고장 원인을 분석하기 위한 핵심 지표임을 시사
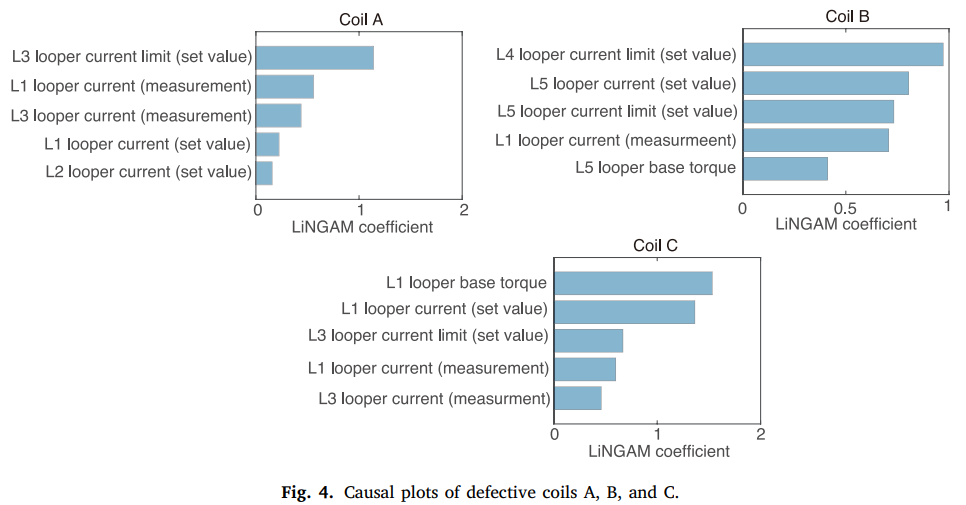
- 지표에 가장 큰 인과적 영향을 미친 상위 5개 변수를 막대 그래프로 나타낸 것
- 코일 A: L3 루퍼의 전류 제한값이 가장 큰 원인으로 지목됨
- 코일 B/C: L4 루퍼 전류 제한값 및 L1 루퍼 베이스 토크 등이 상위에 위치
- 공통적으로 Looper 관련 변수들이 지목되었는데, 이는 tension 조절 문제가 롤링 실패의 직접적인 계기임을 보여줌
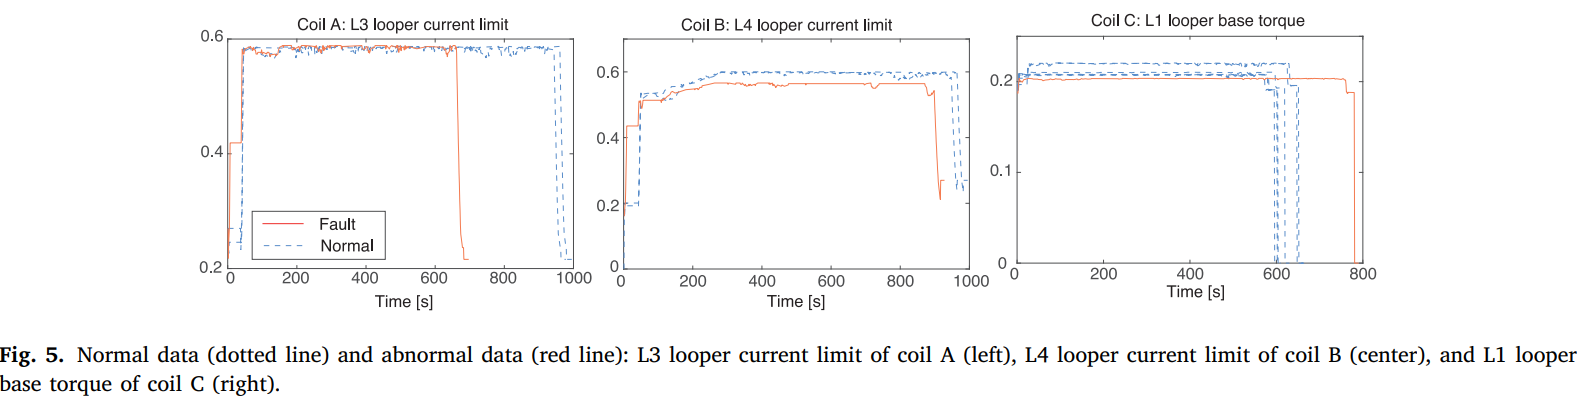
- 인과 분석에서 지목된 주요 변수들의 실제 시계열 흐름을 정상 데이터와 비교
- 코일 A: 정상 데이터에는 없는 일정 수치가 초기에 관찰됨
- 코일 B: 정상 데이터보다 낮은 수치가 지속됨
- 코일 C: 수치 차이는 작지만 정상 범위에서 미세하게 벗어나 다른 변수들에 연쇄적인 영향을 주었음을 암시
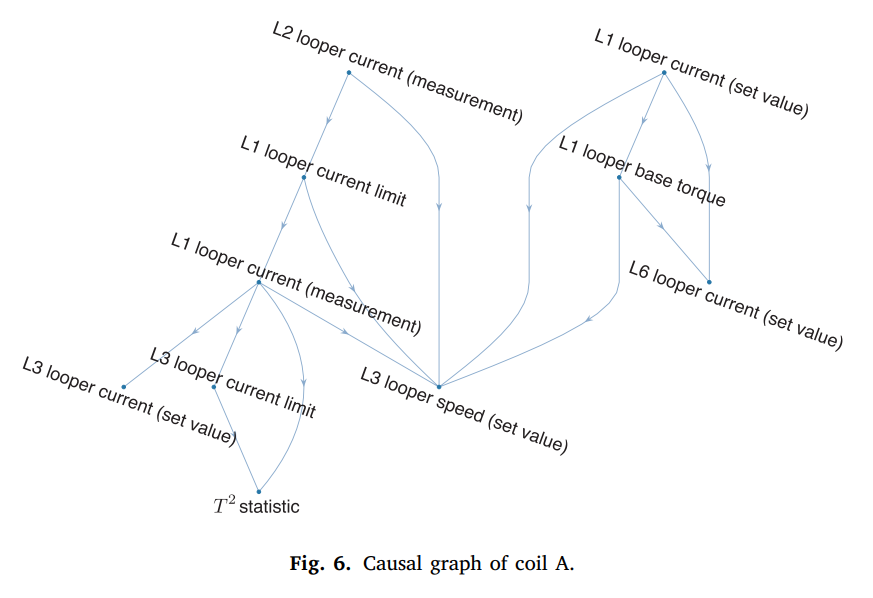
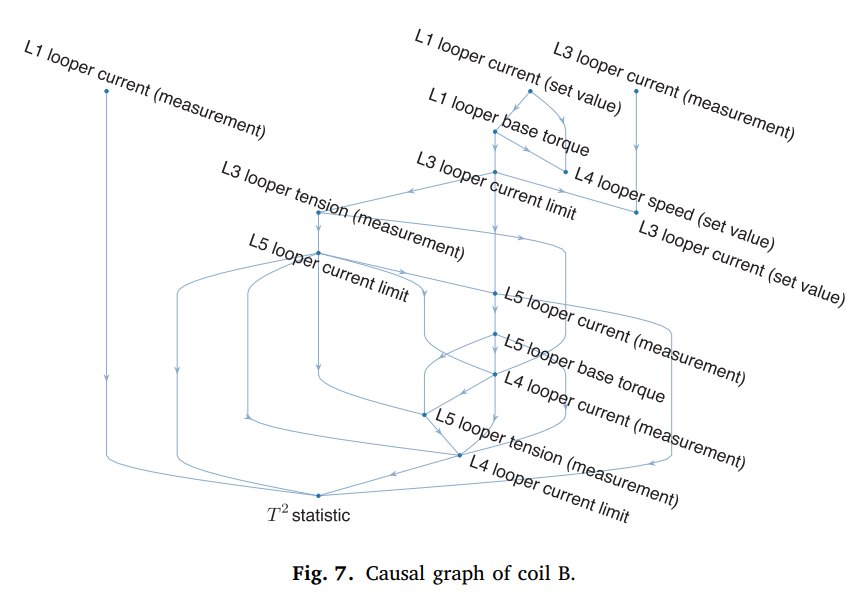
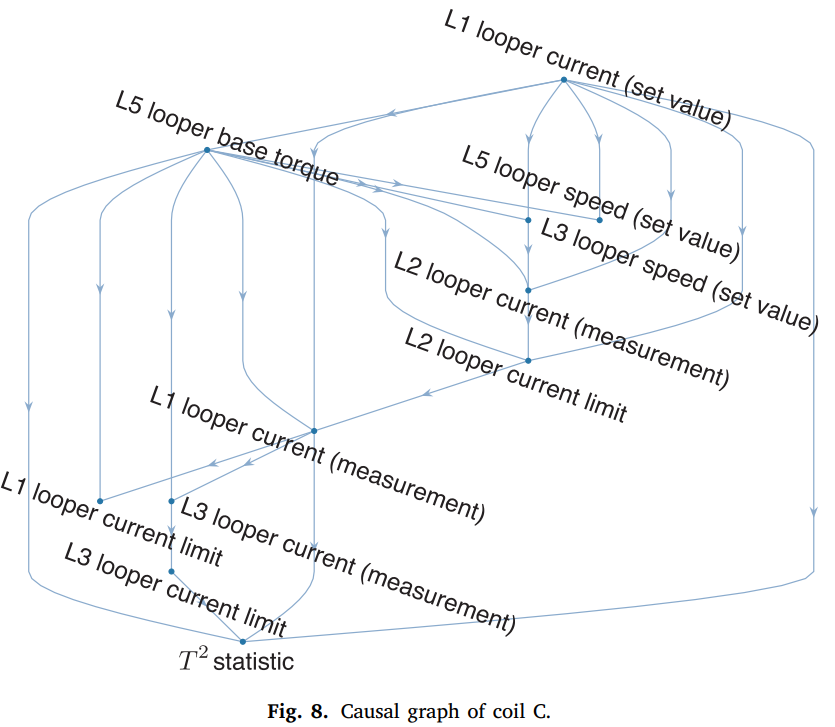
- 변수 간의 인과적 선후 관계를 화살표로 연결한 그래프
- 코일 A (Fig.6): 에 직접 영향을 준 것은 L3 루퍼 변수였지만, 그래프의 origin을 거슬러 올라가면 L1, L2 루퍼 전류가 나옴
- 세 코일 모두 결과적으로 L1 루퍼 관련 변수들이 인과 계통의 최상단에 위치하고 있음을 확인 가능
- 이는 초기 공정(L1)의 문제가 후속 공정(L3, L4)의 이상으로 전이되었음을 보여줌

큰 사람이 되겠어요